有一次,產品在海外出現極少量、卻非常嚴重的失效。
麻煩的是,沒有人看得懂全貌。
現場工程師知道故障發生時的症狀。
公司內部AI查得到多年維修紀錄、BOM與歷史異常。
供應商知道材料製程。
客戶端掌握真正的使用環境。
外部模型找到其他產業曾出現過的類似機制。
程式則把幾百種條件組合重新跑了一遍。
每一邊都有一部分。
沒有任何一邊有全部。
以前遇到這種事情,我們很容易先問:
誰最懂?
找最資深的工程師。
找產品專家。
找顧問。
希望找到一個人,把所有碎片收回腦袋裡。
《明思》的卻可以先換一個問法:
這個問題要被想清楚,究竟需要哪些不同的位置?
這一換,重點就從「找最厲害的人」變成「把需要的認知位置佈出來」。
現場負責真實症狀。
內部AI追歷史。
供應商補材料機理。
外部模型找異領域相似結構。
程式負責大量演算。
再放一個專門反對主流假說的AI,避免大家太早收斂。
這不是把很多人塞進會議室。
而是。
幾輪之後,真正有意思的事情發生了。
現場工程師原本懷疑設備。
材料資料卻顯示,只有某個批次在特定溫濕條件下特別敏感。
客戶端又補了一個公司內部沒有的使用情境。
外部模型提出另一個產業裡曾出現過的類似失效機制。
程式先把材料批次、溫濕條件與使用情境交叉組合,標出失效案例集中在哪幾組條件;團隊再用測試紀錄核對那些組合是否真的出現過,並保留尚未排除的其他原因。
現有資料顯示,單獨任何一項都不足以解釋已知失效。會議原本快要結束,現場工程師卻指著客戶端新補的一段使用紀錄,請大家把那個時間點再對一次。程式重新篩過條件組合,供應商也回頭檢查對應批次。原本彼此說服不了對方的幾份資料,終於開始指向同一個值得實測的組合;至於它是否就是原因,仍待驗證。
真正的問題存在於它們的組合裡。
沒有任何一個人先知道這個答案。
也沒有任何一個AI單獨知道。
答案是它們彼此接起來之後,才出現的。
答案可以存在於關係裡,而不必完整存在於任何一個成員裡。
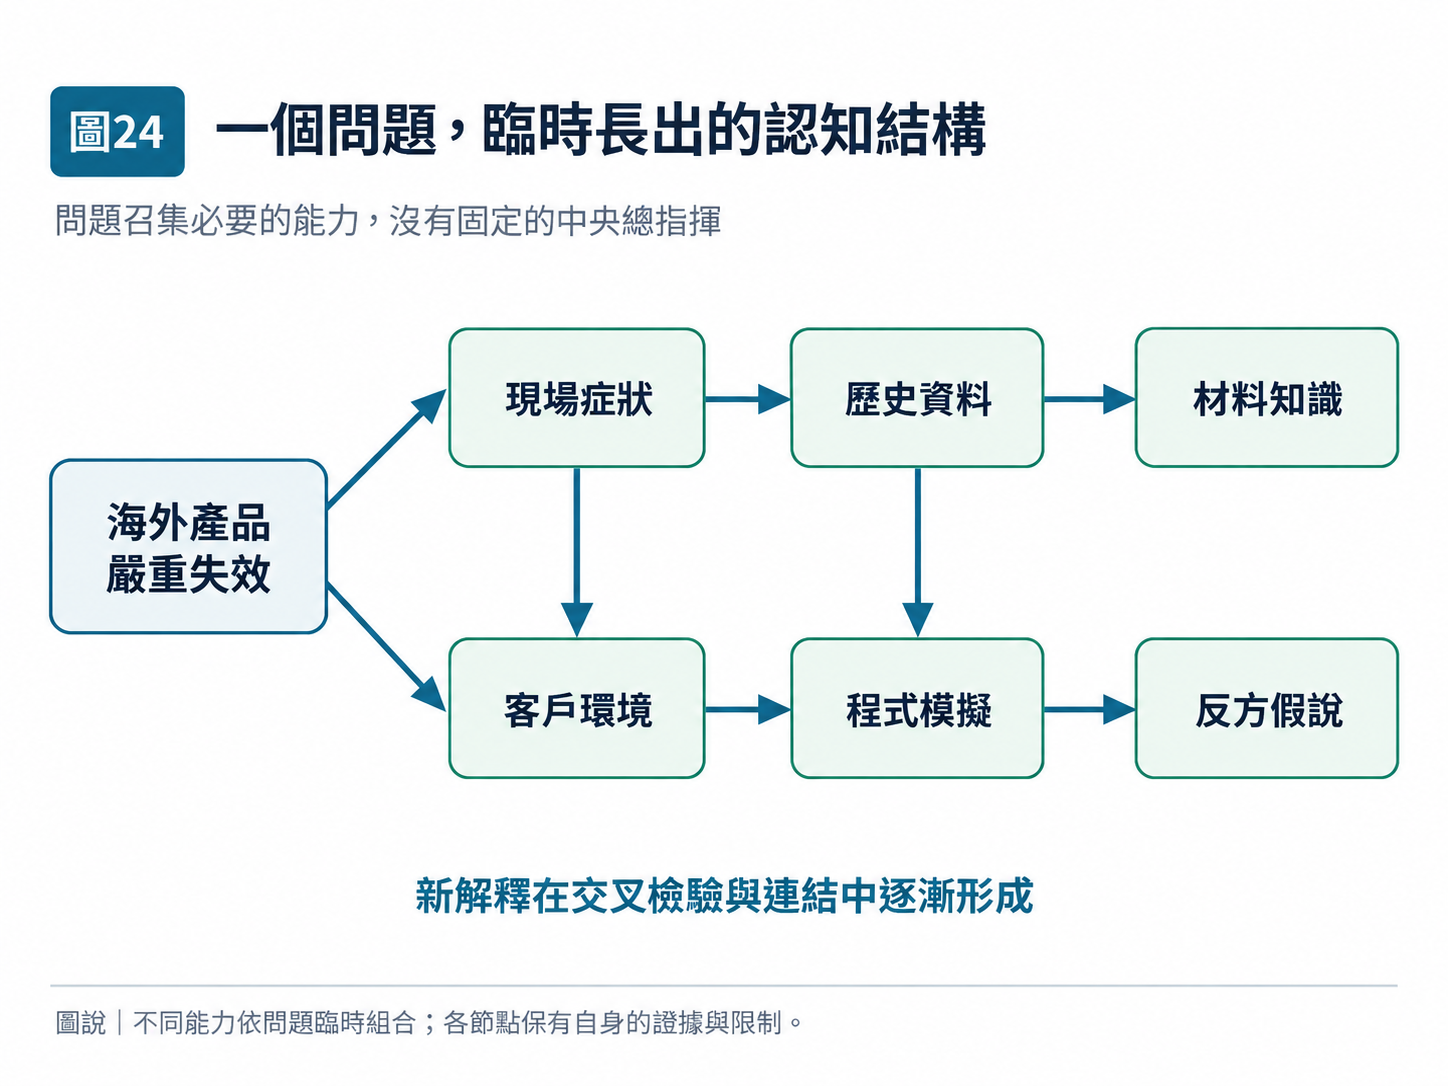
這也讓「團隊」這個詞開始不太夠用。
因為不同問題,需要的根本不是同一組人。
供應鏈異常,可能需要採購、物流、供應商資料、風險模型。
產品創新,需要的又可能是客戶洞察、工程、設計、成本與外部技術情報。
問題結束之後,這個組合甚至可以解散。
下一個問題,再重新長一個。
所以未來的思考單位,未必是:
一個人。
一個部門。
一個固定AI。
甚至一支固定Agent團隊。
它可能是:
一個問題臨時召集出來的一整套認知。
問題先來。
大腦後長。
這裡的「」也有新的意思。
有些能力應該拆開。
讓不同模型獨立判斷,避免互相污染。
有些資訊則必須合起來。
因為原因根本藏在關係中。
所以重點不是越連越好,也不是越分越好。
而是:
哪裡該分,哪裡必須接。
這就是《明思》裡真正派上用場的地方。
但多個智慧放在一起,不代表真的多了智慧。
如果十個Agent:
看同一份資料,
用同一種模型,
接受同一個KPI,
只是換了十個名字,
那很可能只是一個腦袋戴了十頂帽子。
真正要找的不是數量。
而是差異。
不同資訊。
不同限制。
不同經驗。
不同判定方式。
甚至不同的反對理由。
只有差異真的存在,關係才可能長出單一節點原本沒有的東西。
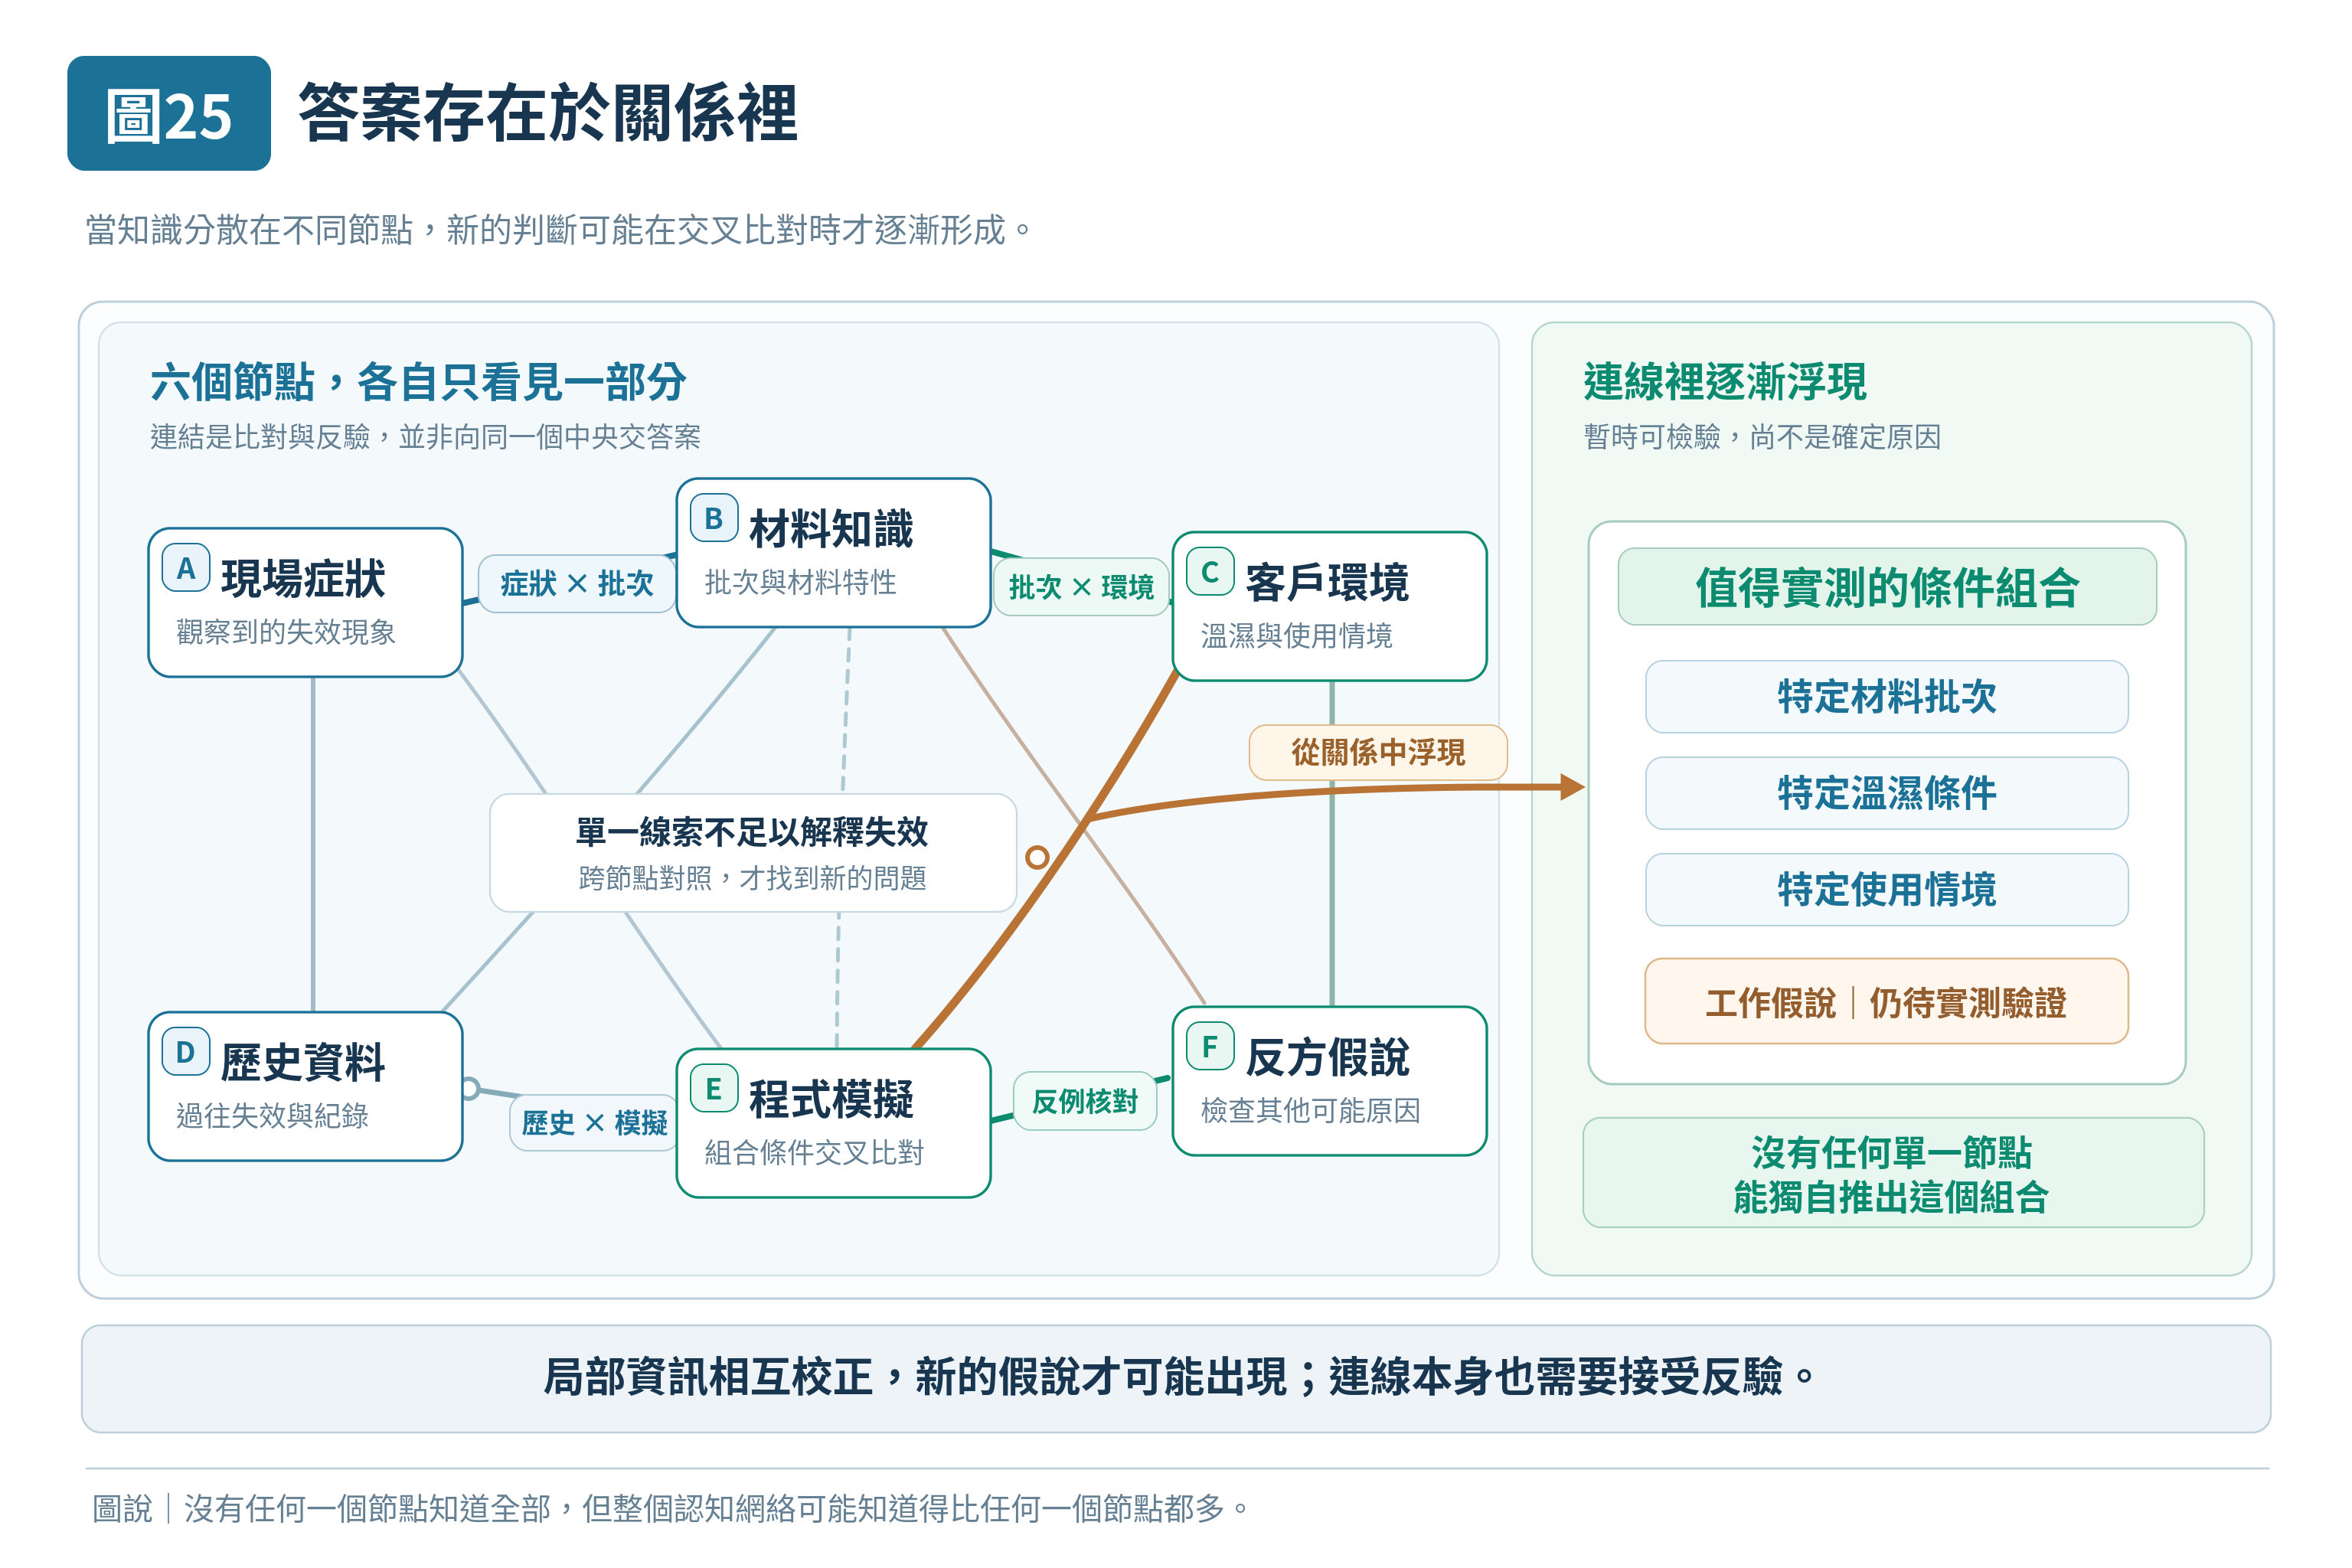
這也帶來一個新的麻煩。
如果答案不是某個人想出來的,也不是某個AI單獨產生的,而是在關係裡逐步形成,
那麼出錯時,不能只問:
「是哪個人錯?」
或者:
「是哪個模型錯?」
也可能是:
資料本身都沒錯。
每個局部判斷也合理。
錯的是兩個判斷被接在一起的方法。
或某個關係被漏掉。
這提醒我們,不能只留節點的輸出。
還要留:
答案是怎麼在關係裡長出來的。
到這裡,思考已經不太像一顆孤立的大腦。
比較像一個會隨問題重新組裝的認知網絡。
如果有一天,一個答案並沒有完整存在於任何一個人或任何一個AI裡,而只存在於它們彼此的關係之中,那麼,我們還能把「誰知道答案」問成一個單數問題嗎?