同一個異常,人和AI常常不是得出不同答案。
而是根本沒有看見同一個東西。
那天,設備的不良率又升了。
AI先抓到一個很漂亮的關聯。
某一批材料進站之後,不良明顯提高。
時間吻合、批次吻合。
幾個主要製程參數也沒有出現明顯漂移。
如果只看資料,第一個判斷很自然:
材料批次可能是主要原因。
工程師看完沒有立刻點頭。
他問:
「那幾天設備是不是修過?」
有人查紀錄。
有。
前幾天換過一個零件。
「換完有重新校正嗎?」
有。
「結果正常嗎?」
正常。
紀錄看起來很完整。
零件更換、功能確認、校正完成、設備復機,一切都在規格裡。
工程師又問:
「那天是正常校,還是趕著復機?」
這句話沒有欄位可以查。
大家開始回想。
那天設備故障得比預期久,後面已經塞了一批料,產線等著復機。
如果照完整流程一項一項重新確認,當班產出肯定達不到。
所以現場先做完必要校正。
數值合格。
設備恢復生產。
沒有任何紀錄是假的。
只是熟悉那台設備的人知道:
「在規格裡」和「已經回到平常的狀態」,不一定是同一句話。
偏偏新材料也差不多在那幾天進站。
資料因此形成一個非常漂亮的故事:
新材料來了。
不良升了。
相關性清楚。
如果只看資料,材料很可疑。
如果只問現場工程師,他又會把注意力放在設備。
兩邊都有證據。
也都有盲點。
這時候,《明思》的不是叫大家選一邊。
也不是把「材料」和「設備」各打五十分。
先不要急著裁判。
把兩個看見的世界放在一起。
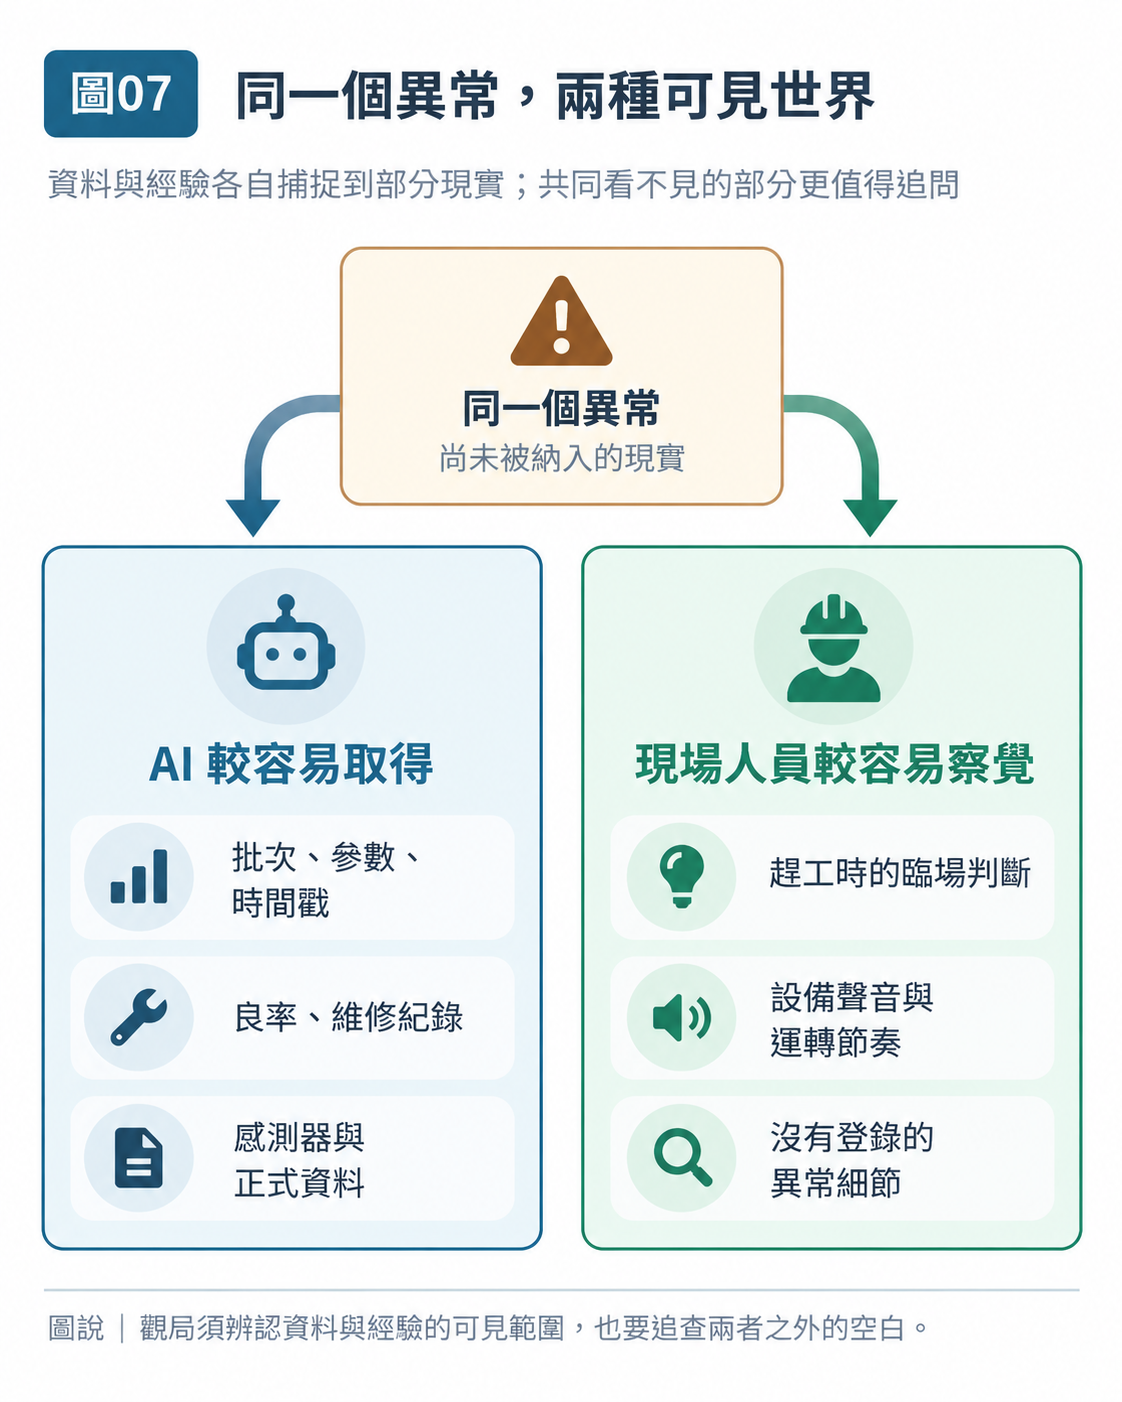
AI看見的是:
時間戳、材料批次、參數、感測值、維修紀錄、品質結果。
工程師看見的是:
復機當時的壓力。
哪一段雖然合規,但做得和平常不一樣。
設備長期使用後應該呈現什麼狀態。
哪些細節沒有嚴重到值得正式登錄,卻讓熟悉現場的人覺得「怪」。
這兩種證詞都不完整。
也正因為不完整,差異才有價值。
我們很容易把這件事簡化成:
人有經驗。
AI有數據。
所以兩邊互補。
這句話雖然好記,卻太乾淨。
因為「人的經驗」裡並不全是智慧。
裡面也有:
習慣、印象、過度自信。
多年沒重新驗過的老說法。
甚至「以前都這樣做」留下來的惰性。
同樣地,「數據」也不是世界本身。
數據是被量出來的。
被選擇保存的。
被欄位切過的。
有人先決定:
什麼值得感測、多久取一次、什麼叫異常、哪些事情不用記。
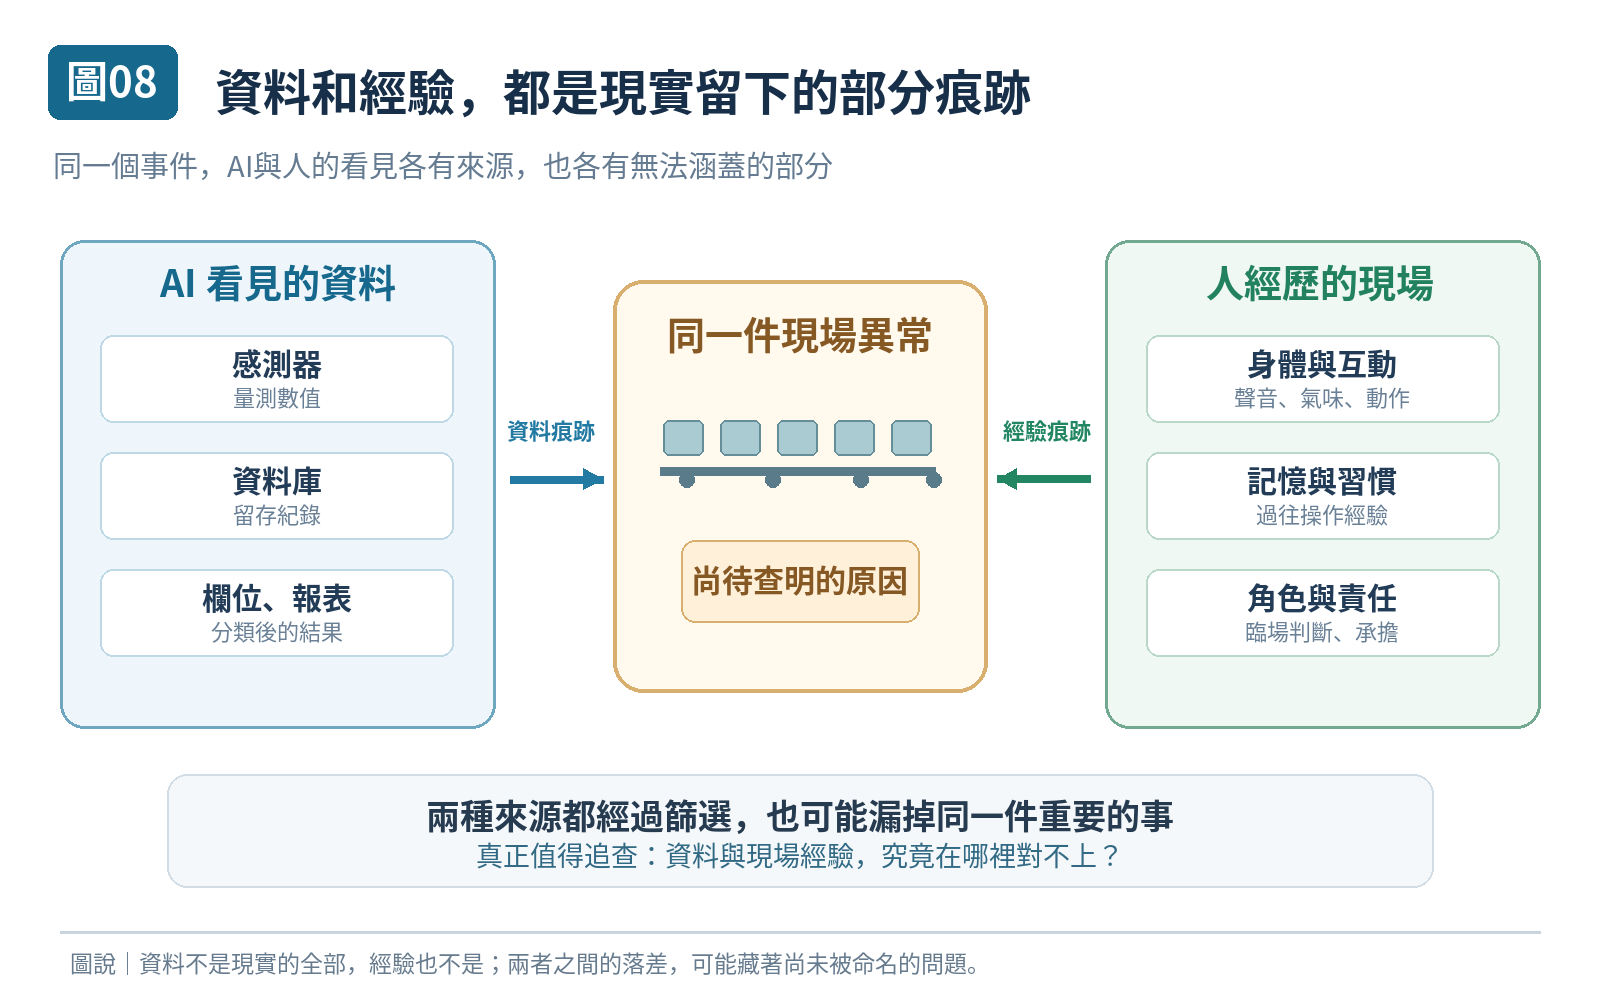
所以AI拿到的不是現實。
是現實被某套量測方式留下的痕跡。
人拿到的也不是現實。
是人在現實裡生活之後留下的痕跡。
如果只把兩邊都當成真相,還是會失明。
真正需要做的,是。
問:
這一種看法最容易漏掉什麼?
另一種呢?
《莊子》的濠梁之辯放到這裡,忽然會有另一點味道。
莊子說魚游得自在,是魚之樂。
惠子問:
「子非魚,安知魚之樂?」
有趣的未必只是誰辯贏。
真正刺人的地方是:
我們憑什麼確定,自己已經知道另一個位置裡的世界?
到了AI時代,這個問題更難躲。
人很容易說:
AI只有數據,不懂現場。
也很容易在另一個時候,看到一份漂亮分析就說:
AI已經看懂了。
這兩種說法表面相反。
骨子裡卻很像。
都在替另一種觀看方式說完它自己還沒說完的話。
所以真正穩妥的不是先判斷:
它懂不懂。
而是問:
它到底能看到什麼?看不到什麼?
這才是。
資料世界有它非常強的地方。
人會忘。
AI可以把幾個月、幾年的資料重新攤開。
人容易被最近發生的事情拉走注意力。
AI可以同時追很多變數。
人很難自己看出幾十個微小條件一起變化時的關係。
AI可能先發現。
所以如果因為一句「AI不懂現場」,就把它降成只能整理報告的助手,同樣是一種看窄。
另一邊,人也有AI無法憑空得到的東西。
那天誰催過復機。
為什麼少做了一個非必要檢查。
操作員當時覺得哪個聲音不太一樣。
某個主管為什麼做了一個沒有寫進流程的決定。
如果這些沒有被留下,AI不會因為模型夠大,就突然擁有。
世界沒有義務把重要的東西都先整理成資料表。
對不上,反而常常是好事。
如果AI說材料最可疑,
現場工程師卻說:
「我還是覺得那台設備不對。」
先別急著決定誰比較厲害。
《明思》的在這裡不是找人犯錯。
而是利用不一致。
為什麼資料指向材料?
為什麼現場指向設備?
有沒有一個兩邊都沒有完整看見的條件,可以同時解釋這兩件事?
這個問題一出來,局開始往外長。
團隊於是重新把時間疊回去。
材料批次、設備維修、參數、環境、不良分布。
一條一條對。
還是有一小部分異常怎麼都解釋不完整。
資料找不到。
現場也沒有人記得發生過什麼。
有人最後問:
「那幾天設備附近是不是還有其他施工?」
這句話一出來,大家才想起來:
隔壁區域那週確實在做工程。
施工紀錄不在製程系統。
沒有人把它當成這個問題的一部分。
再往下追,才發現那段時間局部環境曾經短暫波動。
沒有超過全廠警戒值。
所以沒有任何警報。
對大多數材料也沒有影響。
但對當時那一批比較敏感的材料,加上設備剛復機的狀態,可能已經足夠。
這個條件,AI一開始沒看見。
現場工程師也沒看見。
不是誰比較笨。
而是大家原本畫出的「局」,根本沒有包含那裡。
這就是最容易被誤會的地方。
我們常常以為:
多找幾個人、多接幾份資料、多叫幾個AI。
局就會越來越完整。
未必。
如果所有人都接受同一條邊界,
再多人也可能一起漏掉邊界外面的東西。
所以真正需要的不只是「增加視角」。
還要問:
他們終於開始檢查:目前這個局的邊界,究竟是如何被畫出來的。
這個問題開始碰到「」。
局不是天然有邊。
邊界很多時候是為了管理方便才畫出來的。
製程系統是一個邊界。
廠務系統又是一個。
設備維修是一個。
品質報表再一個。
世界本身卻不一定照著系統權限走。
灰塵不會先問自己屬不屬於製程部。
溫度也沒有部門編制。
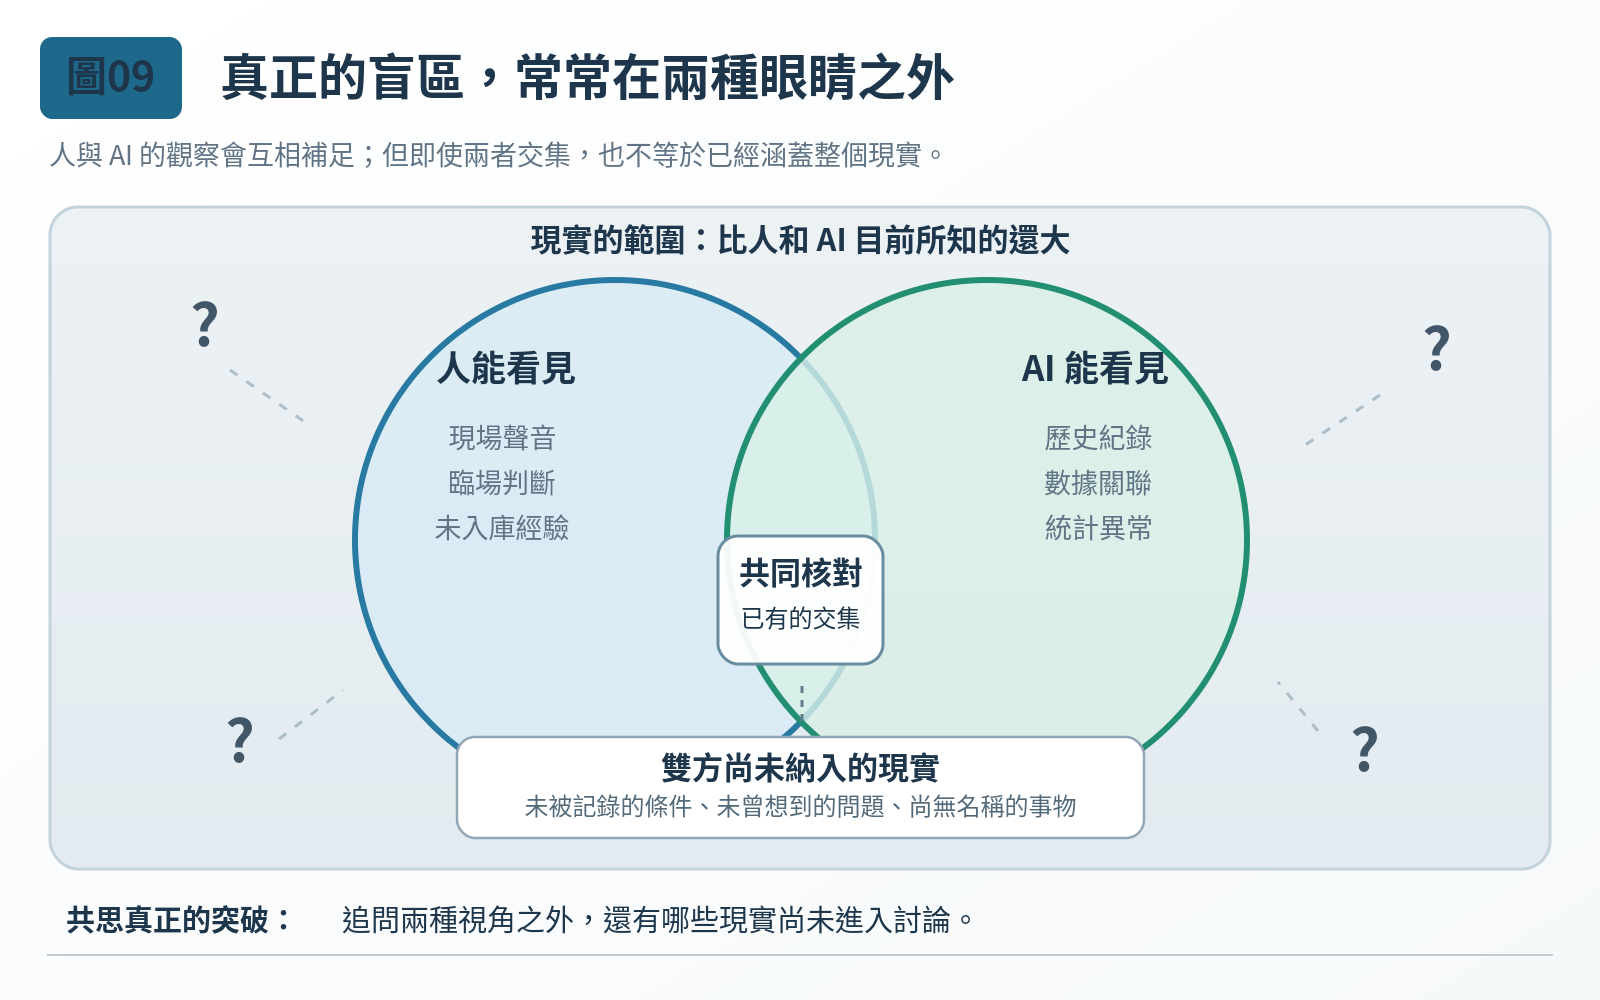
資料庫與現場經驗相互補充後,團隊才注意到自己原先劃定的範圍:維修系統記得零件,製程系統記得參數,品質報表記得結果;現場趕工的壓力與復機後的細微狀態,卻沒有一個完整的記錄位置。
他們於是重新確認哪些資訊真的被觀察過,哪些只是推測,哪些從一開始就不在取樣範圍。材料與設備仍待驗證,但那片未曾被納入的現實,終於有了可以追查的入口。
當人與 AI 都認真檢查了各自看得到的部分,我們又該如何察覺,那個誰都沒有放進局裡的地方?